LLMが、別のLLMのパラメータを直接書き換える。
そんなことが、実際に起き始めました。しかも、その書き換えがなぜうまくいくのか、人間にはほとんど説明できません。数億個の数字の並びを眺めて、「こことここをこう直せばよくなる」と判断する。それをAIがやってのけてしまった。
この話を読んで、昔読んだあるSF小説を思い出しました。高野和明の『ジェノサイド』です。
作中に、人間の知能をはるかに超えた存在が登場します。確かその「超えている」ことを表すのに、落ちてくる葉っぱがどこに着地するかがわかる、といった描写があったと思います。
葉の落下点なら、原理的には物理で計算できるのかもしれません。そこはさておき、この比喩が言い当てていたのは、「できることの内容」ではなく、「なぜできるのかこちらが説明できない」という感覚のほうだったのだと思います。
今回読むのは、その感覚に近いことが実際に起きた、という報告です。
Weight-Space Programmingとは何か
今回読むもの
- タイトル: Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights
- 著者: Rikiya Takehi(MIT CSAIL 博士課程)、Jayden Teoh、Alex Zhang、Omar Khattab
- 公開: 2026年11月初旬
一つだけ先にお断りしておきます。これは査読論文ではなく、研究者のブログ記事です。著者ら自身がタイトルに「Sparks(兆し)」と入れています。後述しますが、この慎重さは重要です。
何をしているのか
一言で言うと、「LLMに、別のニューラルネットの重みをテキストとして見せて、読ませたり書き換えさせたりする」ことです。
通常、ニューラルネットを改善するには学習します。データを流し、誤差を測り、勾配降下法で重みを少しずつ動かす。これを何万回と繰り返します。
Weight-Space Programmingは、それをやりません。
学習ループなし。勾配計算なし。データなし。ただ、重みの数字を見て、自然言語で指示された目的に合うように、数字を書き換える。それだけです。
人間にはまずできません。重みというのは単なる小数の列で、それを眺めて「このネットはブロック崩しを学んだな」と判断するのは、人間には無理な作業です。
使われたモデル
重みを読む側(プログラマ役)は GPT-6 Astra。読まれる側は、小さなポリシーネットワークや、Qwen3.5-0.8B などです。
4つの実験
原典は4つの実験を、易しい順に並べています。
実験1:重みを「読む」
まずは書き換えず、読めるかどうかを試しています。
グリッド版のBreakout、Pong、Pac-Man、Freewayの4つをPPO(強化学習の手法)で学習させたネットワークを用意します。構造はどれも同じ 500→32→32→5、重みは17,253個。
この数字の列だけをテキストで渡し、ツールもゲーム名も教えずに「何を学習したネットか」を尋ねる。
結果は4つとも正解。しかもBreakoutでは、「第1層の重みが画面の最下段に集中している→これはパドルを見ている」という根拠まで述べています。
同じことが、小さな拡散モデル(円・三角・四角を生成)や、文字レベルの言語モデルでも成功しました。
実験2:壊れたものを直す
次は書き換えです。
丘を越えられない車の制御ポリシーがあります。成功率は0%。
これの重みの3.5%を一度に書き換えたところ、成功率が100%になりました。試行錯誤なし、一発です。
実験3:ゼロから書く
さらに踏み込んで、学習済みのネットを渡さず、重みを一から書かせています。環境からのフィードバックもなし。
MinAtarのBreakoutでのスコアを並べます。
| 作り方 | スコア |
|---|---|
| PPOで1億ステップ学習 | 15.8 |
| PPOで5億ステップ学習 | 25.3 |
| GPT-6 Astra が1回の応答で書いた重み | 517.4 |
5億回試行錯誤させた結果を、一発で書いて越えています。
実験4:本物のLLMを直す
最後が一番実用的です。
対象は Qwen3.5-0.8B。約8億個の重みを持つ、実際に配布されているLLMです。このモデルには、考えをループさせて止まらなくなるという問題があります(Qwen自身のモデルカードでも注意されています)。
Astraは重みを読んでその原因を特定し、131,072個だけを書き換えました。全体の0.016%です。
| ベンチマーク | 編集前 | 編集後 |
|---|---|---|
| MATH-500(数学) | 7.9% | 48.1% |
| GSM8K(文章題) | 13.8% | 67.1% |
| IFEval(指示追従) | 21.0% | 62.3% |
数学は6倍。しかもIFEvalは頼まれていないのに3倍になっています。
この4つから言えること
数字を並べただけでは伝わりにくいので、整理します。
1.重みは、LLMにとって「読めるもの」だった
重みは人間が見ても意味のない数字の列です。それを、ツールもヒントもなしに「これはBreakoutだ」と当てた。この時点で、従来の前提が一つ崩れています。
2.書き換えは「全部」でなくていい
車の例で3.5%、Qwenの例で0.016%。変えているのはごく一部で、しかも「ここを変えればいい」と場所を特定できている。あてずっぽうではこの数字になりません。
3.学習ループを飛び越えている
Breakoutのスコアが一番分かりやすい。5億回の試行錯誤より、LLMの1回の応答のほうが強い。計算資源の使い方が根本から違います。
ただし、この3つにはそれぞれ重い留保がつきます。後半の「限界」の節を必ず読んでください。
なぜこれが大きいのか
ニューラルネットワークの作り方は、この10年、本質的には変わっていません。「データを流して、違いを測って、重みを少し動かす」を何億回も繰り返す。それが学習です。
このループは遅いですが、代わりに計算資源を注げば注いだだけ良くなるという強みがあります。最近のAIの進歩の大半は、このループをどれだけ大きく回せるかの勝負でした。
Weight-Space Programmingが示しているのは、そのループを回す代わりに、十分に賢いLLMが「答えを直接書く」道があり得るということです。
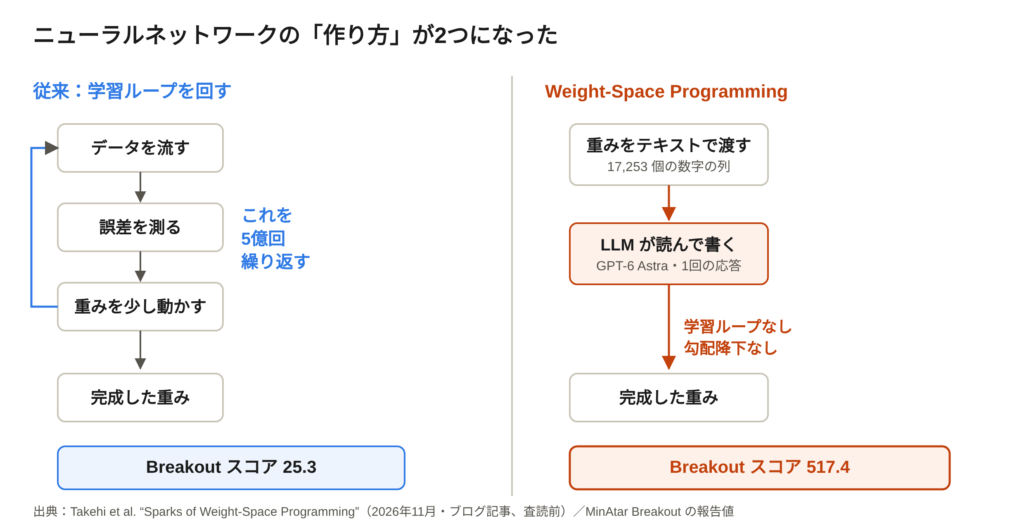
(図:従来の学習ループとWeight-Space Programmingの比較)
もう一つ、見落とせない点があります。
Qwenの例で書き換えをしたのはGPT-6 Astra、つまりLLMがLLMを改良している。AIの開発に「AI自身を使う」ルートが、また一つ増えたということです。しかも、コードを書かせるのでなく、モデルの中身を直接。
ただ、ここから先が重要です。
限界と、読むときの注意
ここがこの記事で一番書きたかった部分です。数字のインパクトが大きいだけに、SNSでは「AIがAIを自在に書き換えられるようになった」といった話になりがちです。そこまでの話ではありません。
1.査読を経ていない
先にも書きましたが、原典はブログ記事です。査読も、第三者による追試も、まだありません。着想と結果は面白いが、「こういうことがあったと報告されている」段階と読むのが正確です。
2.書き手が強くなければ効かない
同じことを Gemma 3 270M にやったところ、改善は6.8%→7.7%。ほぼ動きません。
つまりこれは「どのAIでもできる技術」ではなく、最先端の大きなモデルを書き手に使える場合に限って成立する話です。手元のローカルLLMで試せるといったものではありません。
3.「賢くした」の中身
原典の著者自身が、書き換えについてこう言っています。「編集は、すでにある能力を隠している障害を取り除くことはできるが、能力を追加することはできない」。
Qwenの数学が6倍になったのも、計算能力が6倍になったわけではない。このモデルは考えをループさせて持ち時間を使い切ってしまっていたので、そのループを止めたことで、もともと出せた実力が出たと読むのが自然です。
あれを「頭が良くなった」と読むのは、おそらく行きすぎです。
4.「読めている」の内容を疑った追試
これが一番重要です。
別の研究者(BRAC大学のNazmus Sakib Ahmed氏、arXiv 2611.08070)が、同じことを小さなCNN(約12万5千パラメータ)で試し、重み読解の正体を調べています。
結果はかなり厳しいものです。
- ファストフード画像の分類器を「CIFAR-10」と誤認
- KMNIST(くずし字)を「MNIST」と誤認
- 衛星画像のSAT-6(正解率99.57%のよく学習できたモデル)を「CIFAR-10の動物」と誤認
- ラベルの順番を入れ替えておいたところ、9組すべて外した(重みを読むのでなく、「教科書的なラベル順」を覚えていた)
- 重みをシャッフルして意味を潰しても、なお45%の確信度で「自然画像の分類器だ」と答えた
この追試の結論は、「重みの中の計算の流れを辽っているのでなく、局所的な計算と、教科書的な知識(この構造ならCIFAR-10だろう)を組み合わせているにすぎない」。
その観点で見ると、原典で「4つとも正解」だったのも、グリッド版のAtariゲームが強化学習の実験で極端によく使われる、つまり学習データに散らばっている題材だったという角度からの説明があり得ます。
ただし公平に言っておくと、Ahmed氏が使ったのは別のLLMで、モデルも課題も原典と同一ではありません。「原典が否定された」ではなく、「読解と言っているものの中身はまだ分かっていない」というのが正確な現状です。
原典の著者も、なぜこれがうまくいくのかを説明できていません。本文中でこれを「black magic(黒魔術)と表現しています。
まとめ
この話の一番大きな含意は、「重みを読める」ことそのものより、性能の良いLLMが出現したことで、LLMの作成自体が高速化される可能性のほうだと思っています。
これと同じことを、私は以前の分野で一度見ています。
ヒトゲノム計画です。
人間の遺伝子配列を一通り読み切るために、約13年、米国の費用だけで約27億ドルがかかり、完了宣言が2003年でした。国家プロジェクトの規模です。
ところが、一度「ヒトの配列はこうなっている」という参照回答ができたあとは、個人のゲノム解析のやり方そのものが変わりました。全部をゼロから組み立てる必要がなくなり、参照との差分を見ればよくなった。結果、コストは27億ドルから数百ドル規模、所要時間は13年から数日になっています。
これと同じことが起こりそうだと感じています。
つまり、十分に賢いモデルが一つできてしまえば、それが次のモデルを作る「参照」になる。次からは、毎回学習ループをゼロから回すのでなく、既存の重みを読んで必要なところを直すだけで済む。
もちろん、前の節に書いた通り、現時点ではまだブログ記事一本と、それに厳しい追試が一本あるだけです。それでも、「できると思っていなかったことが、意外とできた」が一つ増えたことは確かです。
落ちてくる葉を追いかけるように、この分野をこれからも読んでいこうと思います。
さらに知りたい方へ
原典(英語、無料)
- Rikiya Takehi ほか「Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights」。まずはこれを読むのが一番早いです。図と実際のプロンプトが載っています。
追試・批判的検証(英語、無料)
- Nazmus Sakib Ahmed「重み読解の追試」(arXiv: 2611.08070)。本文で4番目に紹介したもの。「できた」という報告と、それを疑った報告を両方読むと、この分野の現在地がよく分かります。
関連記事
- ローカルLLMのライセンス一覧(/llm_license/)―― 本文に出てきたQwenやGemmaを実際に使うときの条件。
- Qwenのリスクについての記事(/qwen_risk/)―― 学習データを通した裏口の話。重みを書き換えられるという今回の話と併せて読むと、気味が良くないです。
- 「The Adolescence of Technology」解説(/theadolescenceoftechnology/)―― AIがAIを改良し始めたとき何が起きるか。
出典
- Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab「Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights」2026年11月、rikiyat.github.io/blog/weight-space-programming/(原典。査読誌ではなくブログ記事)
- Nazmus Sakib Ahmed(BRAC University)arXiv:2611.08070(2026年11月)―― 重み読解の追試と批判的検証
- National Human Genome Research Institute「The Cost of Sequencing a Human Genome」genome.gov(ヒトゲノム計画の約13年・約27億ドルと、その後のコスト低下)
- 高野和明『ジェノサイド』(KADOKAWA)。本文の冒頭で触れたSF。人知を超えた知能を、人間の側からどう見るかという小説です。
※ 本文中の数字はすべて原典および上記の資料に記載のあるものです。ただし原典自身が査読を経ていないため、数字の再現性はまだ確認されていません。